
Kubernetes HorizontalPodAutoscaler(HPA)可以用 Prometheus 自訂指標擴縮 Pod,但 Prometheus 指標必須先透過 custom metrics API 或 Prometheus Adapter 暴露給 Kubernetes。這篇筆記的重點是:HPA 的 metrics.object.describedObject 要對到 Prometheus Rule 產出的 label,例如 service: eventqueue,否則 HPA 找不到要用來判斷擴縮的 metric。
Kubernetes HPA 用 Prometheus 自訂指標時要先確認什麼?
Kubernetes HPA 使用 Prometheus 自訂指標前,必須確認 metrics pipeline 已把 Prometheus metric 暴露到 Kubernetes API。HPA 不是直接查 Prometheus,而是透過 custom.metrics.k8s.io 或 external.metrics.k8s.io 取得數值。
Kubernetes 官方文件說明,HPA 控制器會依 HPA 定義查詢 metrics API;custom metrics 需要由 metrics solution vendor 提供 adapter API server,常見做法是使用 Kubernetes SIGs 的 Prometheus Adapter(Kubernetes,2026 年;kubernetes-sigs,2026 年)。
這段範例使用的元件是:
- Prometheus:收集與查詢 metrics。
- Prometheus Operator:用 Kubernetes CRD 管理 Prometheus 與 PrometheusRule。
- Prometheus Adapter 或等效 adapter:把 Prometheus metric 暴露成 Kubernetes custom metrics API。
- Kubernetes HPA:依 metric 計算 Deployment replica 數。
- Rancher:當時叢集管理與 monitoring 環境。
Prometheus Rule 的 label 為什麼會影響 HPA?
Prometheus Rule 的 label 會決定自訂指標能不能被 Kubernetes object metric 正確關聯。HPA 查的是某個 Kubernetes object 的 metric,因此 Prometheus Adapter 需要靠 label 把 time series 對回 Service、Pod 或其他資源。
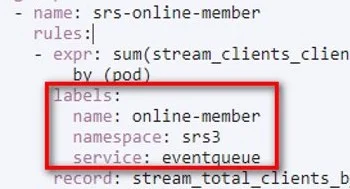
我當時的筆記使用 stream_total_clients_by_pod 作為客製化 metric。這個 metric 來自 Prometheus,要讓 Kubernetes HPA 使用,Prometheus Rule 裡必須加上能對應 HPA describedObject 的 label。
本文範例最重要的是這個對齊關係:
| HPA 欄位 | Prometheus Rule 對應 | 用途 |
|---|---|---|
describedObject.kind: Service | labels.service | 告訴 adapter 這筆 metric 屬於哪一個 Service。 |
describedObject.name: eventqueue | service: eventqueue | 讓 HPA 查 eventqueue 這個 Service 的 object metric。 |
metric.name: stream_total_clients_by_pod | record: stream_total_clients_by_pod | HPA 要查的 metric 名稱。 |
Prometheus 官方文件也提醒,recording rules 會把 PromQL 表達式預先計算成新的 time series,並可透過 labels 新增或覆寫 label(Prometheus,2026 年)。因此 labels.service: eventqueue 不是裝飾欄位,而是 HPA 能不能找到 object metric 的關鍵。
HPA 的 behavior 怎麼設定 scale up 與 scale down?
HPA behavior 可以限制擴容與縮容的速度,避免 Pod 數量因短暫流量波動而快速震盪。這段範例把 scale up 與 scale down 都限制為每 60 秒最多變動 1 個 Pod,縮容穩定視窗設定為 300 秒。
Kubernetes autoscaling/v2 API 文件中,behavior.scaleDown.stabilizationWindowSeconds 代表縮放時會回看過去建議值的秒數;periodSeconds 必須大於 0 且小於或等於 1800 秒;policies.value 必須大於 0(Kubernetes API Reference,2026 年)。
我當時的設定是:如果維持 300 秒都穩定符合縮放條件,HPA 才進行縮放;每 60 秒最多增加或減少 1 個 Pod。
behavior:
  scaleDown:
    policies:
      - periodSeconds: 60
        type: Pods
        value: 1
    selectPolicy: Max
    stabilizationWindowSeconds: 300
  scaleUp:
    policies:
      - periodSeconds: 60
        type: Pods
        value: 1
    selectPolicy: Max
    stabilizationWindowSeconds: 300
實務上,直播、串流或 queue worker 這類負載如果連線數上下跳動很快,stabilizationWindowSeconds 可以避免剛縮容又立刻擴容。代價是反應會慢一點,所以要依服務能不能承受短時間排隊來調整。
HPA 的 Object metric 怎麼引用 Prometheus 指標?
HPA 的 Object metric 會針對單一 Kubernetes object 取得 metric,並把目前值與目標值比較。這段範例用 Service/eventqueue 的 stream_total_clients_by_pod 指標作為縮放依據。
Kubernetes HPA MetricSpec 支援 Resource、Pods、Object、External 與 ContainerResource 五種 metric source;ObjectMetricSource 需要 describedObject、metric 與 target(Kubernetes API Reference,2026 年)。
這段設定表示:HPA 查詢 eventqueue 這個 Service 物件上的 stream_total_clients_by_pod 指標,目標值設定為 1k。
metrics:
  - object:
      describedObject:
        apiVersion: v1
        kind: Service
        name: eventqueue
      metric:
        name: stream_total_clients_by_pod
      target:
        type: Value
        value: 1k
    type: Object
如果 Prometheus Adapter 的規則是把 metric 對到 Pod,而不是 Service,HPA 就不應該寫成 type: Object 加 kind: Service。這時要改成 type: Pods,或調整 adapter 規則讓 service label 能對到 Service resource。排查時先用 kubectl get --raw /apis/custom.metrics.k8s.io/... 確認 API 裡看得到哪種 resource path。
完整 HPA YAML 範例怎麼寫?
完整 HPA YAML 需要同時包含 scale target、replica 上下限、behavior 與 metrics。這段範例保留當時使用的 autoscaling/v2beta2 寫法;新叢集建議改用穩定版 autoscaling/v2。
Kubernetes 官方文件標示,自訂指標擴縮在 Kubernetes v1.23 起以 autoscaling/v2 成為 stable,autoscaling/v2beta2 先前提供 beta 能力(Kubernetes,2026 年)。如果叢集版本已支援 autoscaling/v2,建議把 apiVersion 更新為 autoscaling/v2。
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: srs-edge
  namespace: srs3
spec:
  behavior:
    scaleDown:
      policies:
        - periodSeconds: 60
          type: Pods
          value: 1
      selectPolicy: Max
      stabilizationWindowSeconds: 300
    scaleUp:
      policies:
        - periodSeconds: 60
          type: Pods
          value: 1
      selectPolicy: Max
      stabilizationWindowSeconds: 300
  maxReplicas: 2
  metrics:
    - object:
        describedObject:
          apiVersion: v1
          kind: Service
          name: eventqueue
        metric:
          name: stream_total_clients_by_pod
        target:
          type: Value
          value: 1k
      type: Object
  minReplicas: 1
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: srs-edge
scaleTargetRef 設定的是 HPA 要調整哪個 workload 的 replica 數。這段範例要擴縮的是 apps/v1 的 Deployment/srs-edge,不是 Service/eventqueue。Service/eventqueue 只是 metric 的描述物件。
設定完成後要怎麼排查 HPA custom metric?
HPA custom metric 排查要從三個方向看:Prometheus 是否有資料、adapter 是否暴露 metric、HPA 是否引用到同一個 object 與 metric name。只看 HPA YAML 通常不夠。
我會照這個順序查:
- 在 Prometheus 查
stream_total_clients_by_pod是否有值。 - 確認 Prometheus Rule 有加
labels.service: eventqueue。 - 確認 Prometheus Adapter 規則有把
servicelabel 關聯到 Kubernetes Service resource。 - 用 Kubernetes custom metrics API 查得到 Service object metric。
- 用
kubectl describe hpa -n srs3 srs-edge看 HPA event 與目前 metric value。
常見錯誤是 metric 在 Prometheus 查得到,但 Kubernetes custom metrics API 查不到。這通常代表 adapter discovery、resource association、metric naming 或 query template 沒有對上;Prometheus Adapter 文件把這四段稱為 Discovery、Association、Naming、Querying(kubernetes-sigs,2026 年)。
常見問題
Kubernetes HPA 可以直接讀 Prometheus metric 嗎?
Kubernetes HPA 通常不會直接查 Prometheus。HPA 會查 Kubernetes metrics API,因此 Prometheus metric 需要透過 Prometheus Adapter 或其他 adapter 暴露到 custom.metrics.k8s.io 或 external.metrics.k8s.io。
HPA Object metric 和 Pods metric 差在哪裡?
Object metric 描述單一 Kubernetes object,例如某個 Service 或 Ingress 的指標。Pods metric 描述 scale target 底下每個 Pod 的指標,HPA 會把 Pod 指標平均後再與 target 比較。
Prometheus Rule 一定要加 service label 嗎?
Prometheus Rule 不一定永遠要加 service label,但這段範例需要。因為 HPA 的 describedObject 指向 Service/eventqueue,Prometheus Adapter 必須能用 service: eventqueue 把 metric 對回 Service。
autoscaling/v2beta2 還能用嗎?
是否能用 autoscaling/v2beta2 取決於叢集版本。Kubernetes v1.23 起自訂指標擴縮在 autoscaling/v2 已是 stable,新環境建議改用 apiVersion: autoscaling/v2。
HPA 找不到 custom metric 時要先查哪裡?
HPA 找不到 custom metric 時,先查 Prometheus 裡 metric 是否存在,再查 Prometheus Adapter 是否把 metric 暴露到 Kubernetes custom metrics API。最後才檢查 HPA YAML 的 metric.name、describedObject.kind、describedObject.name 是否完全對齊。
參考資料
- Kubernetes,〈Horizontal Pod Autoscaling〉,存取日期:2026-08-28。
- Kubernetes,〈HorizontalPodAutoscaler autoscaling/v2 API Reference〉,存取日期:2026-08-28。
- Prometheus,〈Defining recording rules〉,存取日期:2026-08-28。
- Prometheus,〈Recording rules naming practices〉,存取日期:2026-08-28。
- kubernetes-sigs,〈Prometheus Adapter configuration documentation〉,存取日期:2026-08-28。
延伸閱讀
- 使用 Prometheus 自定義指標為 Kubernetes 做 HPA 縮放:同樣聚焦 Prometheus、Kubernetes,可接著比較不同情境的做法。
- Prometheus Operator 是什麼?Kubernetes 監控的自動化利器:同樣聚焦 Prometheus、Kubernetes,可接著比較不同情境的做法。
- Prometheus Exporter 是什麼:資料格式、Targets 與 PromQL 查詢:同樣聚焦 Prometheus、Kubernetes,可接著比較不同情境的做法。
最後更新
2026-08-28
關於作者
Claire Chang | 企業 AI 導入與流程轉型顧問。專注於 AI Agent 架構設計、ERP 系統整合與企業 AI 治理。
首次發布:2023-04-14