
基於神經網路的語言模型是一種利用深度學習技術,特別是透過循環神經網絡(RNN)或注意力機制(Transformer)的模型,來處理自然語言文本並生成下一個詞彙的模型。這篇文章整理這類模型相較於傳統方法的特點、T5 的序列對序列架構、大型語言模型(LLM)的演化與特殊能力,以及微調的基本流程。
神經網路語言模型相較於傳統方法有哪些特點?
相較於傳統的統計式方法,這種模型具有以下特點:
- 直接學習預測下一個詞彙: 這些模型直接從大量的文本資料中學習,不需要手動設計特徵或規則。它們通過觀察先前的詞彙序列,學習預測接下來的詞彙。
- 利用詞彙向量表徵語意資訊: 在進行預測時,這些模型使用詞彙的向量表示,這些向量捕捉了詞彙之間的語意關係。這使得模型能夠捕捉到詞彙之間的語義相似性,而不僅僅是單純的字符匹配。
- 克服死板的字符匹配: RNN 和 Transformer 網絡並不僅僅是計算連續 N 個詞彙的頻率,它們能夠捕捉到更複雜的詞彙之間的關係,包括不同詞彙之間的語義相似性和語境相依性。
- 減少稀疏性: 由於詞彙向量化,模型能夠減少稀疏性,從而可以從有限的資料中學習到更豐富的詞彙組合和上下文意義。這意味著即使在有限的資料情況下,模型也能夠產生更加流暢和自然的文本。
依據用戶的指示,LLMs 可以執行各種從所未見的新任務,甚至不需要任何樣本、範例。
T5(Text-to-Text Transfer Transformer)模型的架構與限制
T5 的核心思想是:所有自然語言處理的任務,都可以化為序列對序列的生成任務。
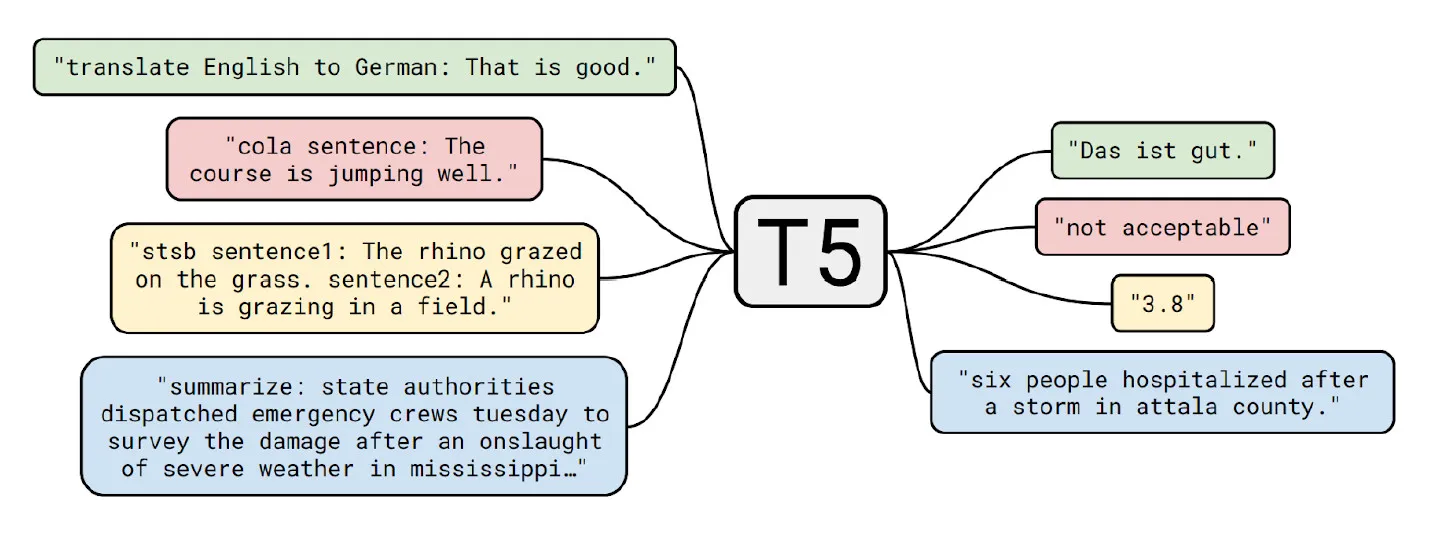
不過 T5 這類模型也有缺點,包括:
- 只能執行已經學過的任務
- 對提示極其敏感,無法泛化
- 缺乏推理能力,無法處理新任務
- 即使在已知任務上,性能也可能有限
- 有著輸入和輸出長度的限制
LLM 的演化歷史與三大特殊能力
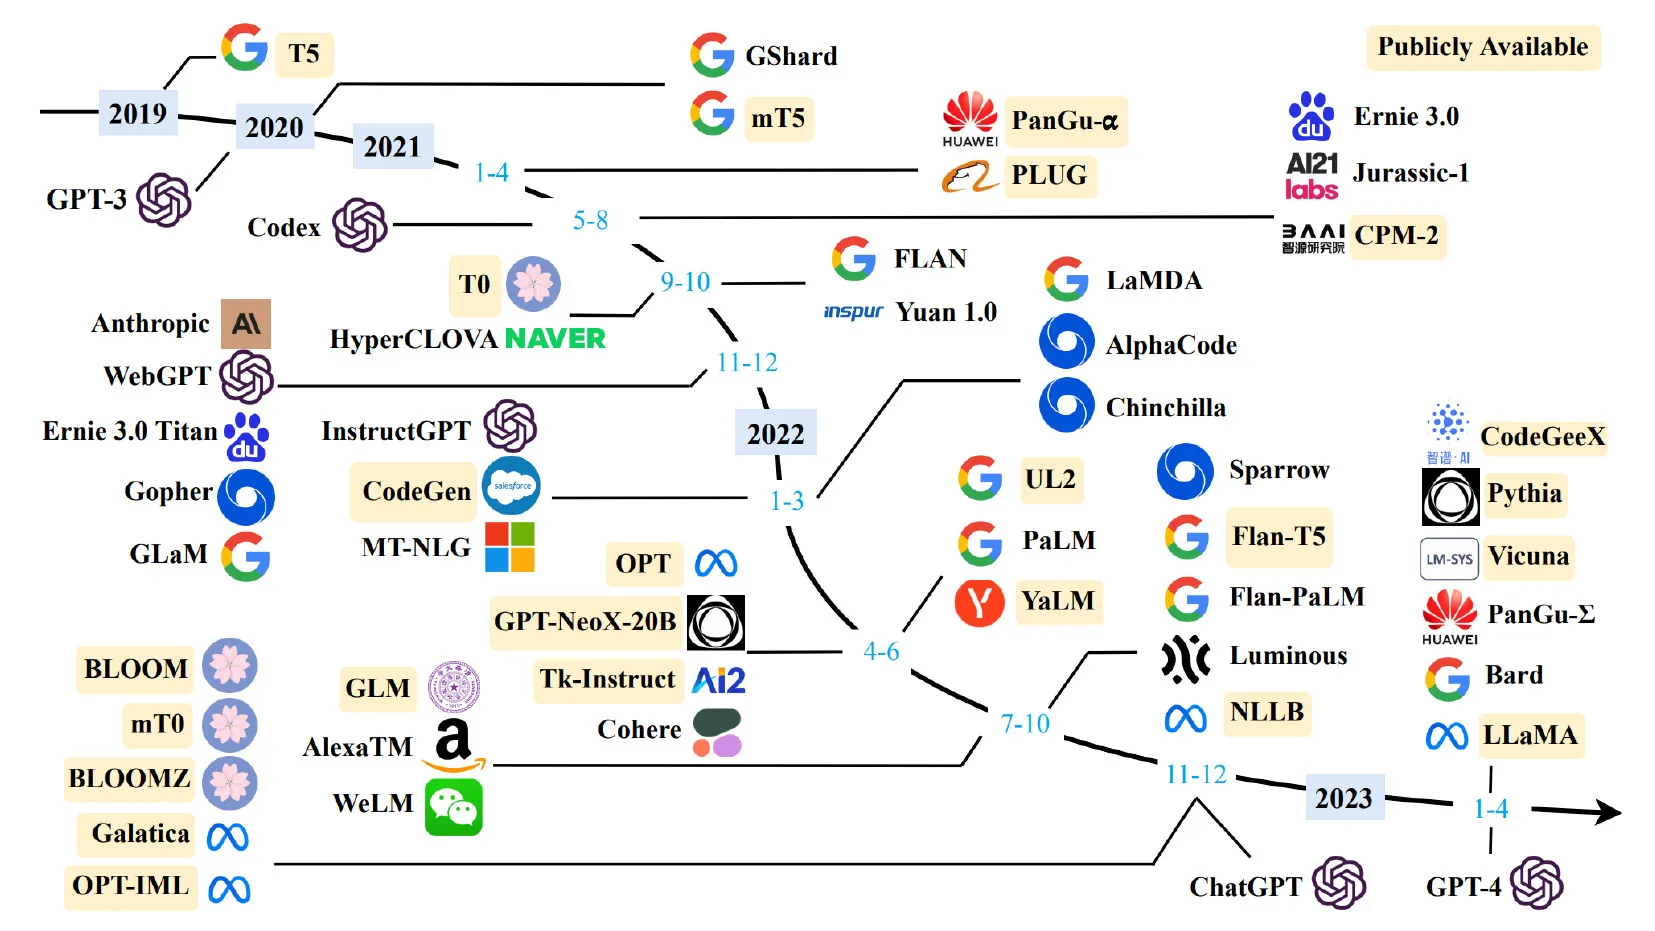
從演化歷史來看,大型語言模型具有以下特別能力:
- In-context learning(上下文學習): 這些模型能夠通過理解輸入文本的上下文來進行學習和產生輸出。它們能夠利用先前的信息和對話歷史來生成更加連貫和相關的回應。
- Instruction following(遵循指示): 大型語言模型能夠理解和遵循輸入中的指示或命令。它們能夠從自然語言描述中抽取出指示的含義,並執行相應的操作或生成符合指示的輸出。
- Step-by-step reasoning(逐步推理): 這些模型能夠通過逐步推理的方式來解決複雜的問題。它們能夠理解問題的各個步驟,從中推斷出答案或採取相應的行動,進而解決問題。
語言模型的微調過程是怎麼進行的?
微調過程如下:
- 從預訓練的 GPT 模型開始。
- 使用反向傳播算法訓練模型以最小化誤差。
- 使用上下文學習技術提高模型的性能。
- 使用元梯度 AWICL 算法進一步提高模型的性能。
下圖顯示了微調過程的各個步驟:
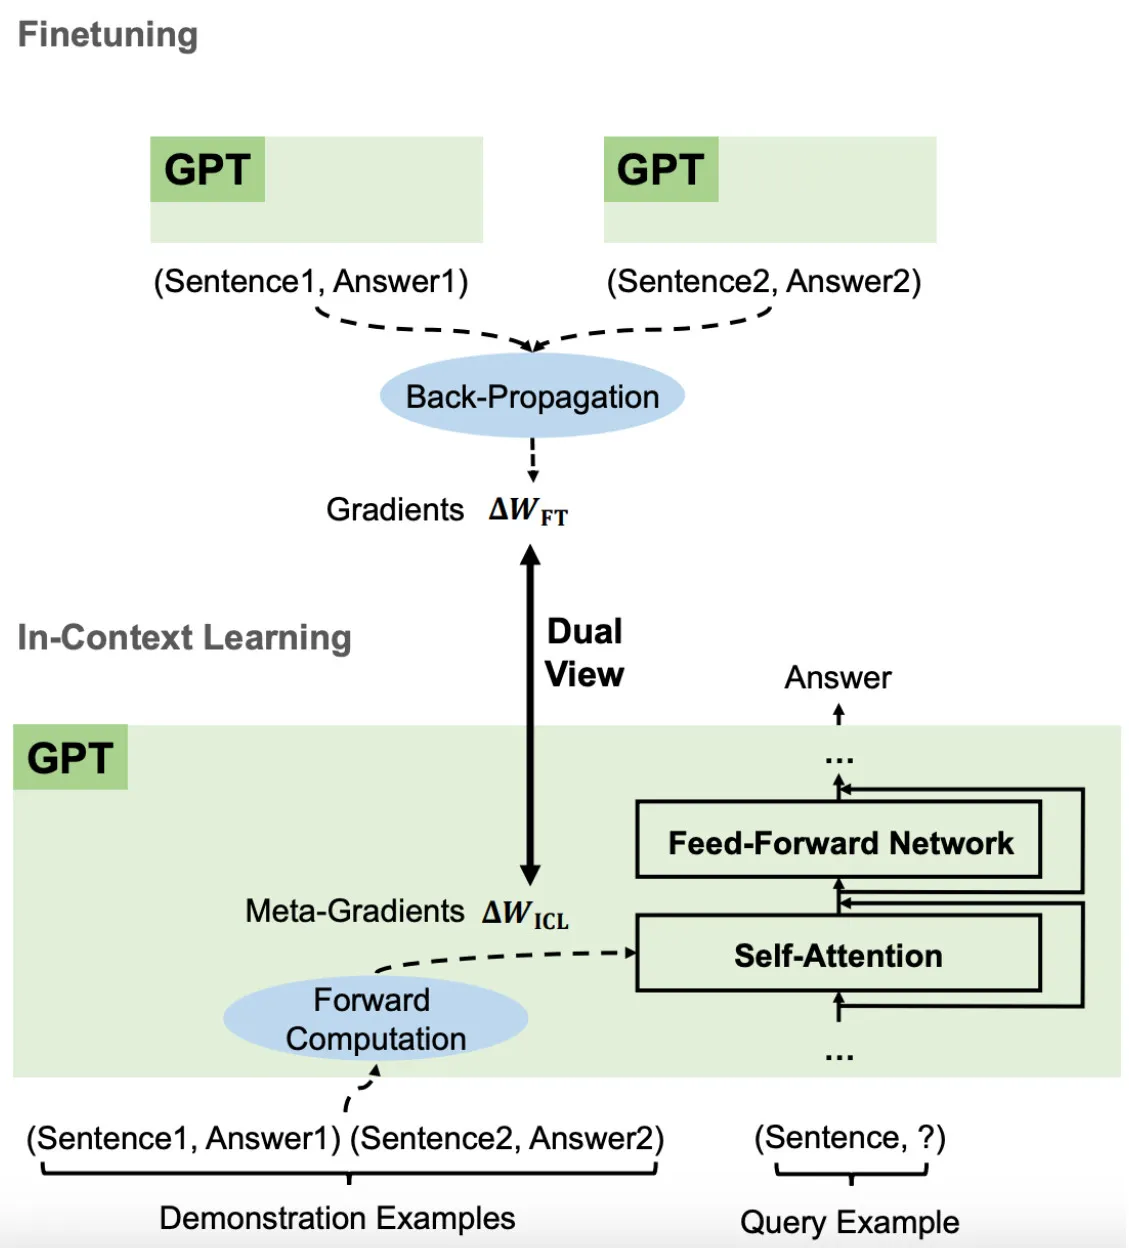
其中,Dual View 是一種上下文學習技術,允許模型考慮輸入句子和查詢句子的上下文。它通過向模型提供兩個視圖來實現:一個是輸入句子的視圖,也就是提供給模型的示範範例與其上下文,讓模型從中歸納任務模式;另一個是查詢句子的視圖,也就是待預測的目標句子。模型同時權衡這兩個視圖的資訊,再決定輸出,藉此提升上下文學習在有限樣本下的表現。
從 2024 之後回看:微調的最佳實務演進
以我現在的角度回看這篇筆記,微調大型語言模型的做法已經演進得更成熟,補充幾個現行的主流方向:
- 指令微調(Instruction Tuning):在預訓練模型上以大量「指示—回應」配對資料進行監督式微調(SFT),這是讓模型具備遵循指示能力的關鍵步驟,也是 ChatGPT 之後各家模型的標配。
- 人類回饋強化學習(RLHF):用人類偏好的排序資料訓練獎勵模型,再以強化學習(如 PPO)優化語言模型,使輸出更符合人類期望。後續也有 DPO 等較輕量的替代方案。
- 參數高效微調(PEFT):像 LoRA、QLoRA 這類方法只訓練少量新增的低秩矩陣,而不動原始權重,讓你在單張消費級顯示卡上也能微調數十億參數的模型,大幅降低成本。
- 上下文學習與微調互補:Zero-shot、Few-shot 的上下文學習適合快速驗證,微調則適合需要穩定格式、領域知識或風格一致的任務。實務上通常先用提示工程,效果不夠再考慮微調。
常見問題
基於神經網路的語言模型和傳統統計式語言模型最大的差別是什麼?
神經網路語言模型直接從大量文本學習預測下一個詞彙,並利用詞彙向量捕捉語意關係。傳統方法依賴詞彙頻率統計,容易受稀疏性影響,也無法理解語義相似性和語境相依性。
T5 模型的核心概念是什麼?
T5 的核心概念是「所有自然語言處理任務都可以化為序列對序列的生成任務」,把翻譯、摘要、分類等任務統一成文字對文字的格式。不過它只能執行學過的任務、對提示敏感且缺乏推理能力。
大型語言模型有哪些特別的能力?
主要有三種:上下文學習(in-context learning)、遵循指示(instruction following)與逐步推理(step-by-step reasoning)。這些能力讓 LLM 能依據使用者指示執行從未見過的新任務,甚至不需要任何樣本或範例。
為什麼詞彙向量化能減少稀疏性問題?
因為模型用連續向量表徵詞彙,語義相近的詞在向量空間中彼此接近,不必為每個詞彙組合保留獨立的統計計數。因此即使訓練資料有限,模型也能學到更豐富的詞彙組合與上下文意義,產生更流暢自然的文本。
LLM 的微調流程包含哪些步驟?
典型的微調流程是:從預訓練的 GPT 模型開始,用反向傳播算法訓練以最小化誤差,接著搭配上下文學習技術提升性能,最後可用元梯度 AWICL 算法進一步強化。Dual View 這類技術則讓模型同時考慮輸入與查詢句子的上下文。
參考資料
- 本文為我 2024-05-01 的部落格筆記整理。
延伸閱讀
- Transformer:自然語言處理的里程碑:同樣聚焦 Transformer、NLP,可接著比較不同情境的做法。
- QLoRA 量化微調完整解析:用 4-bit 顯存高效微調大型語言模型:同樣聚焦 LLM,可接著比較不同情境的做法。
- 模型的權重與偏差值是什麼?神經網路 Weight、Bias 與訓練更新概念:同樣聚焦 神經網路,可接著比較不同情境的做法。
最後更新
2026-08-28(原文發布於 2024-05-01,本文保留原始筆記內容並補上 GEO 結構。)
關於作者
Claire Chang | 企業 AI 導入與流程轉型顧問。專注於 AI Agent 架構設計、ERP 系統整合與企業 AI 治理。
首次發布:2024-05-01