
要微調(fine-tune)LLM,資料集的品質往往比模型架構更影響成果。這篇筆記整理 NLP 資料集在微調前的用途、整理的五個步驟(收集、清理、預處理、標註、切分),附上一段最小可行的 TF-IDF 前處理範例程式碼,以及幾個常用的 NLP 工具。
LLM 的訓練過程與資料集格式長什麼樣?
先看 LLM 訓練過程中,資料是怎麼被組織成模型可用的格式——每一筆資料(instance)通常包含任務描述(task description)、示範(demonstrations,可選)、輸入(input)與期望輸出(output):
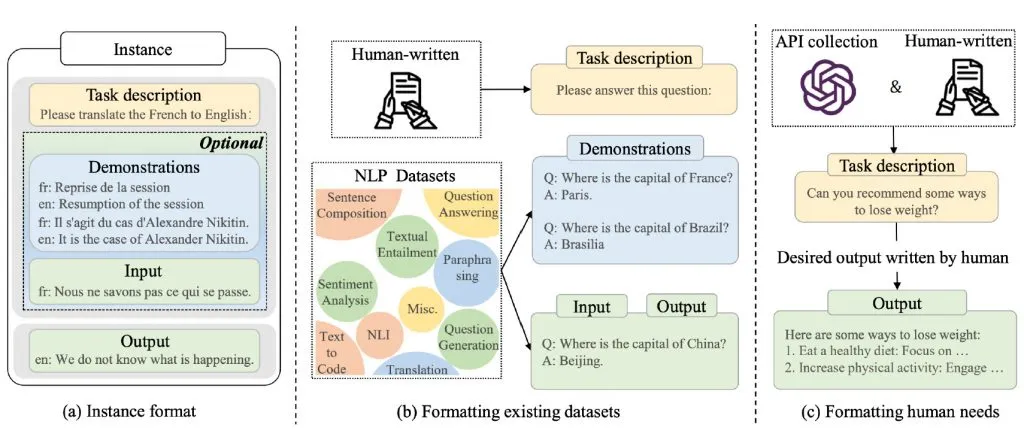
NLP 資料集可以用來演示各種 NLP 任務,例如:
- 情感分析
- 分類
- 命名實體識別
- 機器翻譯
NLP 資料集在微調中扮演輸入與輸出兩種角色:
- 輸入:為模型提供訓練資料,幫助模型學習如何執行特定任務。
- 輸出:用來評估模型的性能,幫助確定模型是否有效以及該如何改進。
整理 NLP 資料集要走哪五個步驟?
- 收集數據:首先要收集要使用的數據,數據可以來自各種來源,例如網路、書籍或其他媒體。
- 清理數據:收集完數據後,需要清理數據——刪除不需要或錯誤的資料,並糾正錯誤或不一致之處。
- 預處理數據:把數據轉換成模型可以輕鬆處理的格式,這可能包括把文字轉成數字表示、切分句子或移除停用詞。
- 標註數據:對於某些 NLP 任務,需要標註數據,也就是把正確的答案或標籤分配給每個資料點。
- 拆分數據:最後把數據拆成訓練、驗證與測試集——訓練集用來訓練模型、驗證集用來評估訓練過程中的表現、測試集用來評估最終性能。
有沒有簡單的整理範例程式碼?
以下是一個用 TF-IDF 把文字轉成向量、再存成 CSV 的簡單範例:
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer

# Load text data
text_data = ["This is a sample text.", "Another text sample.", ...]

# Preprocess text data (e.g., remove special characters, convert to lowercase)
preprocessed_text = [t.strip().lower() for t in text_data]

# Tokenize text data
tokenized_text = [t.split() for t in preprocessed_text]

# Vectorize tokenized text using TF-IDF
vectorizer = TfidfVectorizer(max_features=5000)
X = vectorizer.fit_transform(tokenized_text)

# Assign labels to the vectorized data (e.g., sentiment analysis, classification)
y = ...

# Create a Pandas DataFrame with the preprocessed data and labels
df = pd.DataFrame({'text': preprocessed_text, 'label': y})

# Save the dataset to a file or database for future use
df.to_csv('nlp_dataset.csv', index=False)
這段程式碼示範了「預處理 → 分詞 → 向量化 → 加上標籤 → 存檔」的最小流程,實務上收集到的原始資料通常還需要更多清理(去除雜訊、統一編碼、處理缺漏值),才適合直接餵進這個流程。
有哪些工具可以幫忙整理 NLP 資料集?
- NLTK:廣泛使用的 Python 自然語言處理庫,包含許多用於數據清理、預處理和標註的工具。
- spaCy:另一個流行的 Python 自然語言處理庫,同樣包含清理、預處理與標註工具,且在生產環境的執行效率上有一定優勢。
- Stanford CoreNLP:史丹佛大學開發的 Java 庫,提供完整的 NLP 標註工具集。
常見問題
微調資料集一定要自己標註嗎?
不一定。如果任務有現成的公開資料集可用,可以先評估是否符合需求;沒有合適資料集時,才需要走收集、清理、標註的完整流程。
資料清理和資料標註是同一件事嗎?
不是。清理是移除錯誤或不需要的資料、修正格式問題;標註則是替每個資料點加上正確答案或分類標籤,兩者是資料準備流程中先後不同的步驟。
訓練、驗證、測試集要怎麼分配比例?
沒有絕對標準,常見做法是訓練集占大多數(例如 70-80%),其餘平均分給驗證集與測試集。實務上應該依資料總量與任務複雜度調整,資料量越小,越需要留意驗證/測試集是否有足夠代表性。
微調 LLM 用的資料集也適用這套流程嗎?
核心原則一致——收集、清理、標註、切分都要做。不過 LLM 微調更強調資料格式(任務描述+輸入+輸出對)與多樣性,且通常需要把資料轉成模型框架要求的格式(如 JSONL),預處理的細節會依模型而不同。
參考資料
延伸閱讀
- LLM 微調是什麼?與 RAG 的選擇與資料準備挑戰:同樣聚焦 Fine-tuning、NLP,可接著比較不同情境的做法。
- 準備數據集資料的方針:機器學習訓練資料品質、數量與篩選原則:同樣聚焦 資料前處理,可接著比較不同情境的做法。
- OpenAI 模型微調(Fine-tuning)完整流程:資料準備到上線實戰:同樣聚焦 Fine-tuning,可接著比較不同情境的做法。
最後更新
2026-08-28(原文發布於 2024-05-01,本文保留原始筆記內容並補上 GEO 結構。)
關於作者
Claire Chang | 企業 AI 導入與流程轉型顧問。專注於 AI Agent 架構設計、ERP 系統整合與企業 AI 治理。
首次發布:2024-05-01