
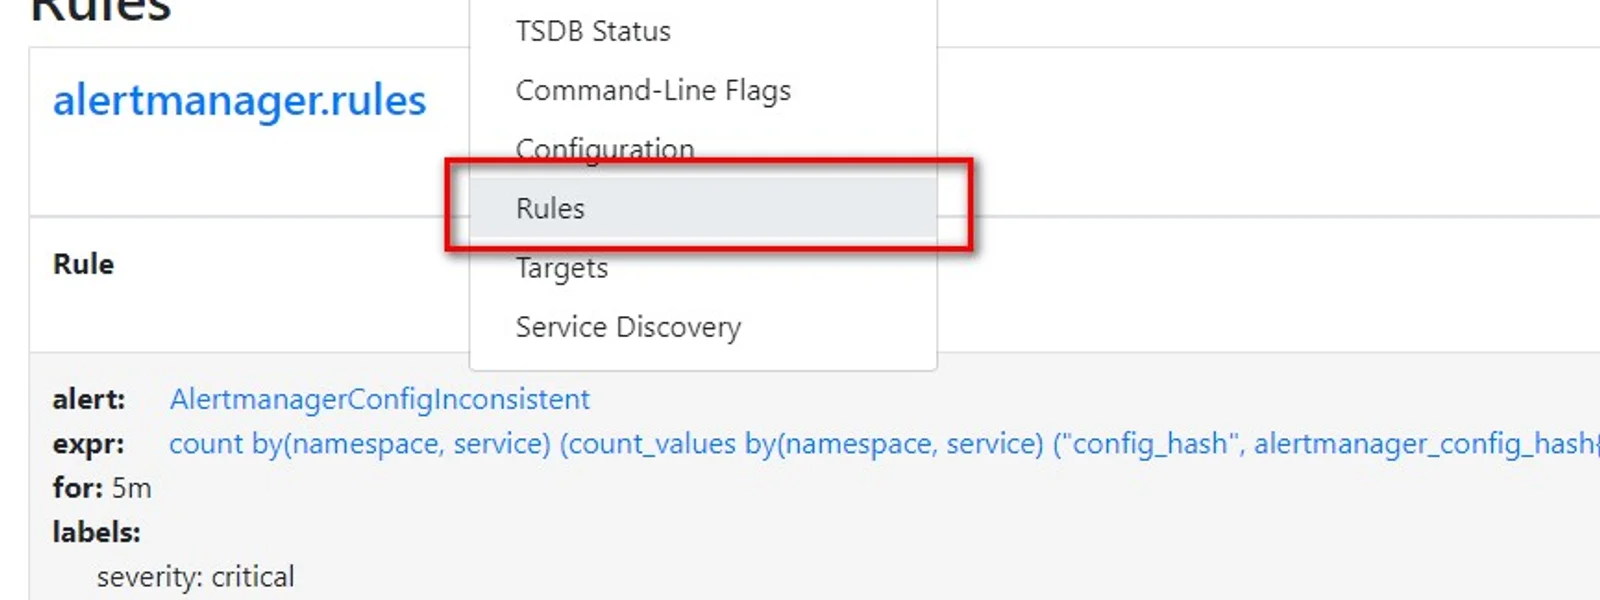
Prometheus Rule 用來把 PromQL 查詢變成可重複載入的監控規則。常見用法有兩種:recording rule 先把複雜查詢計算成新的 metrics,alert rule 則在 metrics 符合條件並持續一段時間後產生告警。
這篇筆記保留一段 PrometheusRule YAML 範例,示範如何統計 SRS edge pod 的線上人數,並在單一 pod 人數大於 1000 且持續 5m 時觸發 warning 告警。
Prometheus Rule 是什麼?
Prometheus Rule 是 Prometheus 的規則設定,用來定義可重複執行的 PromQL 計算與告警條件。Prometheus Operator 環境通常會用 PrometheusRule 這個 Kubernetes CRD 管理規則。
Prometheus Rule 是用於在 Prometheus 中定義規則的 YAML 配置文件。Prometheus 可以根據指定的表達式或條件對 metrics 進行匹配和計算,並在達到一定條件時生成警報或建立新的 metrics。
主要功能可以分成四類:
| 功能 | 說明 |
|---|---|
| Metrics 計算 | 透過 PromQL 表達式對符合條件的 metrics 進行匹配和計算,產生新的 metrics。 |
| 警報 | 當符合指定條件的 metrics 達到閾值時,產生告警。 |
| 規則綁定 | 為指定 metrics 綁定規則,讓監控條件可以自動判斷。 |
| 標籤與註解 | 在告警產生時加上自訂 labels 與 annotations,方便後續統計、路由與分析。 |
通常搭配 Grafana 等圖形化介面使用時,Prometheus Rule 可以讓使用者自訂需要監控的 metrics,並在 Grafana 上實現對 metrics 的即時監控與告警,以便處理系統異常。
PrometheusRule YAML 要怎麼設定?
PrometheusRule YAML 會把規則放在 spec.groups 底下,每個 group 可以包含一個或多個 rule。Recording rule 使用 record 欄位,alert rule 使用 alert 欄位。
下面是一個 PrometheusRule YAML 配置文件,用於定義 Prometheus 規則,以檢測和警報指定的 metrics。
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  labels:
    name: srs-online-member
  name: srs-online-member
  namespace: stu-srs
spec:
  groups:
  - name: srs-online-member
    rules:
    - expr: sum(stream_clients_clients{container="json-exporter", name=~".+",namespace=~"stu-srs",pod=~"srs-edge.+"})
        by (pod)
      labels:
        name: online-member-high
        namespace: stu-srs
        service: eventqueue
      record: stream_total_clients_by_pod
  - name: quay-alert.rules
    rules:
    - alert: online-member-full
      annotations:
        message: online-member-full {{ $labels.pod }} at {{ $value }}%
      expr: sum(stream_clients_clients{container="json-exporter", name=~".+",namespace=~"stu-srs",pod=~"srs-edge.+"})
        by (pod) > 1000
      for: 5m
      labels:
        severity: warning
這份文件定義了兩個規則組,每個規則組包含一個或多個規則:第一組負責產生新的 time series,第二組負責在條件成立時產生告警。
Recording Rule 如何產生新的 metrics?
Recording rule 會把 PromQL 查詢結果預先計算並存成新的 time series。這種做法適合重複查詢、Grafana dashboard 或後續告警規則共用同一段計算邏輯。
第一個規則組名為 srs-online-member,包含一個 recording rule。這個規則透過下列表達式求和符合條件的 metrics:
sum(stream_clients_clients{container="json-exporter", name=~".+",namespace=~"stu-srs",pod=~"srs-edge.+"}) by (pod)
這些 metrics 來自 stream_clients_clients,且必須滿足三個條件:
- namespace 是
stu-srs。 - container 名稱是
json-exporter。 - pod 名稱符合正則表達式
srs-edge.+。
如果條件滿足,Prometheus 會建立名為 stream_total_clients_by_pod 的時間序列,其中 pod 是保留下來的 label,值是各 pod 符合條件的 client 總數。Grafana 可以直接顯示這個 recording rule 產生的 time series,也可以拿來做後續分析。
Alert Rule 如何設定觸發條件?
Alert rule 會在 PromQL 條件成立時進入告警判斷,並可用 for 要求條件持續一段時間才真正觸發。這能避免瞬間尖峰立刻變成告警。
第二個規則組名為 quay-alert.rules,包含一個 alert rule。這個規則會檢查符合條件的 metrics 是否大於 1000:
sum(stream_clients_clients{container="json-exporter", name=~".+",namespace=~"stu-srs",pod=~"srs-edge.+"}) by (pod) > 1000
如果條件滿足 5 分鐘以上,Prometheus 會發出名為 online-member-full 的告警,並加上 severity: warning 與 message annotation,方便後續在 Prometheus Web UI、Alertmanager 或 Grafana 中判讀。
severity: warning 和 annotations 代表什麼?
severity: warning 是告警路由與分級常用的 label,annotations 則提供人可以閱讀的說明文字。Prometheus Alertmanager 或 Grafana 告警流程通常會依 labels 分組、靜音或派送通知。
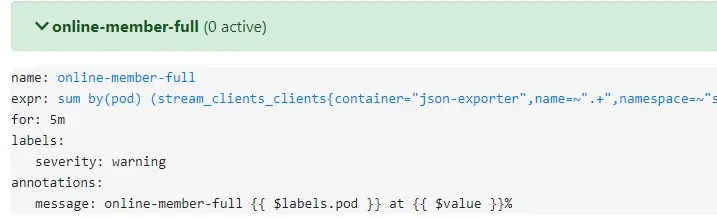
下面這段代表:當符合 selector 的 pod 人數大於 1000 且超過 5 分鐘時,觸發 online-member-full 告警。
- name: quay-alert.rules
  rules:
  - alert: online-member-full
    annotations:
      message: online-member-full {{ $labels.pod }} at {{ $value }}%
    expr: sum(stream_clients_clients{container="json-exporter", name=~".+",namespace=~"default",pod=~"my-pod.+"})
      by (pod) > 1000
    for: 5m
    labels:
      severity: warning
{{ $labels.pod }} 會帶出觸發告警的 pod label,{{ $value }} 會帶出當下查詢值。實務上,我會把 labels 用於機器判斷,例如 severity、namespace、service;annotations 則用於通知訊息,例如問題描述、dashboard 連結或 runbook 連結。
設定後要去哪裡確認 Alert 是否載入?
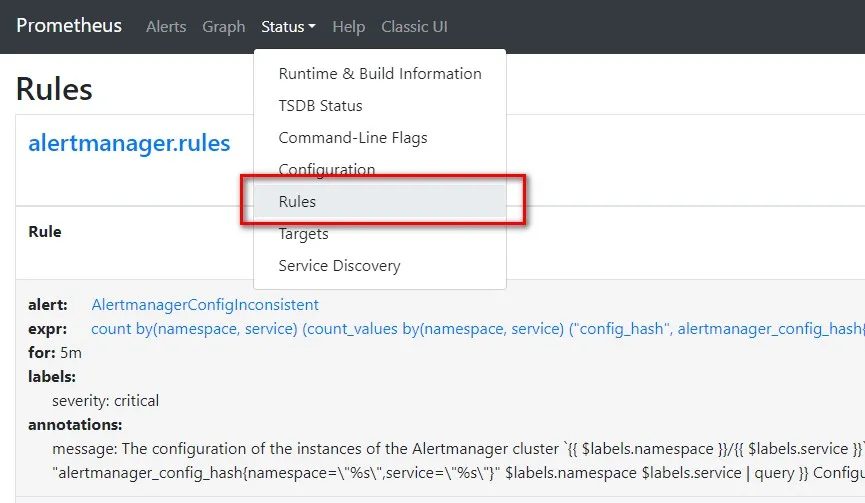
Prometheus Web UI 的 Alerts 頁籤可以確認 alert rule 是否載入,以及目前狀態是 inactive、pending 或 firing。Rules 頁籤則適合檢查 recording rule 與 alert rule 的完整內容。
可以在 Prometheus Web UI 的 Alert 頁籤裡找到這個設定值。
排查時我會照這個順序看:
Status > Rules:確認PrometheusRule是否已被 Prometheus 載入。Alerts:確認 alert name、labels、annotations 與狀態是否正確。- PromQL expression:單獨執行
expr,確認查得到資料。 for: 5m:如果狀態停在 pending,確認條件是否真的連續成立 5 分鐘。
常見問題
Prometheus Rule 和 PrometheusRule 是同一個東西嗎?
Prometheus Rule 是 Prometheus 的規則概念,包含 recording rule 與 alert rule。PrometheusRule 是 Prometheus Operator 提供的 Kubernetes CRD,用來在 Kubernetes 裡管理這些規則。
Recording rule 和 alert rule 差在哪裡?
Recording rule 會把 PromQL 結果寫成新的 time series,方便 dashboard 或其他規則重複使用。Alert rule 會判斷 PromQL 條件,條件成立後產生告警。
for: 5m 是什麼意思?
for: 5m 代表告警條件必須連續成立 5 分鐘才會 firing。若條件只短暫超過門檻,Prometheus 會進入 pending 或直接回到 inactive,不會立刻觸發正式告警。
Alert rule 裡的 labels 和 annotations 要怎麼分?
Labels 適合放機器要判斷的分組與路由資訊,例如 severity、service、namespace。Annotations 適合放給人看的說明,例如 message、dashboard 連結或處理步驟。
PrometheusRule 設定完成但 Alerts 頁籤看不到怎麼辦?
先確認 Prometheus Operator 是否選到這個 PrometheusRule,再到 Prometheus Web UI 的 Status > Rules 看規則是否載入。若 rule 已載入但 alert 沒出現,單獨執行 expr 檢查 PromQL 是否有資料。
參考資料
- Prometheus Alerting rules:https://prometheus.io/docs/prometheus/latest/configuration/alerting_rules/
- Prometheus Recording rules:https://prometheus.io/docs/prometheus/latest/configuration/recording_rules/
- Prometheus Operator API Reference:https://prometheus-operator.dev/docs/api-reference/api/
延伸閱讀
- Prometheus 資料如何用 Web UI、Grafana 與 API 顯示:同樣聚焦 Prometheus、Grafana,可接著比較不同情境的做法。
- Prometheus Exporter 是什麼:資料格式、Targets 與 PromQL 查詢:同樣聚焦 Prometheus、Grafana,可接著比較不同情境的做法。
- 使用 Prometheus 自定義指標為 Kubernetes 做 HPA 縮放:同樣聚焦 Prometheus,可接著比較不同情境的做法。
最後更新
2022-12-16(本文保留 2022-12-16 的 PrometheusRule 筆記內容,並補上 GEO 結構、Answer Blocks、FAQ 與站內延伸閱讀。)
關於作者
Claire Chang | 企業 AI 導入與流程轉型顧問。專注於 AI Agent 架構設計、ERP 系統整合與企業 AI 治理。
首次發布:2022-12-16