
這篇文章整理我在開發 Python GPU 程式時的關鍵觀念:GPU 與 CPU 運算的本質差異、如何在 TensorFlow 中用 tf.device 指定運算裝置、為什麼要避免資料頻繁地在 CPU 與 GPU 之間轉換,以及讓 GPU 發揮最大效益的實務做法。
GPU 運算與 CPU 運算有什麼不同?
以下是 GPU 和 CPU 之間的幾個主要區別:
- 運算單元:GPU 通常具有數百甚至數千個運算單元,而 CPU 通常只有幾十個運算單元。
- 並行運算能力:由於 GPU 具有更多的運算單元,它能夠同時處理更多的數據,因此在並行運算方面具有優勢。
- 計算能力:在單位時間內,GPU 的計算能力通常要高於 CPU。
- 功耗:由於 GPU 具有更多的運算單元,它的功耗通常比 CPU 高。
- 用途:GPU 專門用於圖形處理,通常用於遊戲、視頻播放和圖形設計等任務;CPU 則是計算機的中央處理器,負責處理各種計算任務。
對深度學習來說,模型訓練大部分是大量的矩陣運算,正好是 GPU 並行架構最擅長的工作,這也是為什麼 GPU 訓練速度可以比 CPU 快上好幾倍。
如何在 TensorFlow 中指定使用 GPU?
在程式中使用 GPU 時,需要在執行模型訓練或推理時將運算放在 GPU 上。可以使用 TensorFlow 的 tf.device 函數指定運算的裝置,例如將運算放在第一個可用的 GPU 上:
with tf.device('/gpu:0'):
  # 在這裡放置您的運算
  pass
另外,也要注意 GPU 記憶體使用量。當模型變得越大,可能需要更多的 GPU 記憶體。可以使用 TensorFlow 的 tf.config.experimental.set_virtual_device_configuration 函數設定虛擬裝置配置,指定可用 GPU 的記憶體數量。
開發 GPU 程式最大的不同是什麼?
對開發人員而言,最大的不同就是:GPU 運算需要將資料載入 GPU 裡面,而當資料在 GPU 裡面時,我們沒辦法像資料在 CPU 上時那樣,很方便地使用 print 來查看內容。
也因此,針對支援 GPU 的陣列運算庫,通常在做陣列運算時會呼叫相關的方法去做運算,例如:
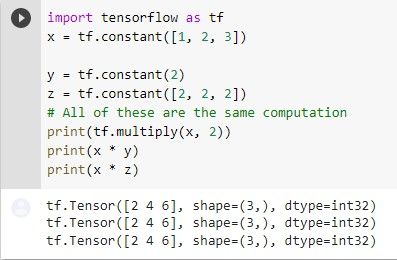
另外在載入資料時,也要注意使用既有可使用 GPU 載入資料的函數載入資料至正確的 GPU 上(例如 tf.data),避免資料頻繁地在 GPU 和 CPU 之間轉換。
如何避免資料頻繁地在 GPU 和 CPU 之間轉換?
要避免資料頻繁地在 GPU 和 CPU 之間轉換,可以考慮以下幾點:
- 將資料放在 GPU 上:使用
tf.device函數指定資料所在的裝置。 - 將運算和資料放在同一個 GPU 上:這樣可以避免資料在 GPU 和 CPU 之間頻繁轉換。
- 使用高效的數據讀取方式:使用 TensorFlow 的數據讀取功能(例如
tf.data)可以更有效地讀取和轉換數據,並減少磁碟 I/O 的負擔。
資料在裝置之間搬移是 GPU 程式最常見的效能殺手之一——每一次轉換都有固定的傳輸成本,資料量越大、轉換越頻繁,訓練速度就被拖得越慢。
如何更高效地使用 GPU?
- 將運算放在 GPU 上:使用
tf.device函數指定運算的裝置。 - 設定虛擬裝置配置:使用
tf.config.experimental.set_virtual_device_configuration函數指定可用 GPU 的記憶體數量。 - 使用數據平行:將模型的數據分成多個 batch 並同時在多個 GPU 上訓練,可以提升訓練速度。可以使用 TensorFlow 的
tf.distribute.StrategyAPI 來實現數據平行。 - 調整 batch size:適當調整 batch size 可以平衡訓練速度和 GPU 記憶體使用量。
如何讓 TensorFlow 自動最佳化使用 GPU?
TensorFlow 可以自動偵測可用的 GPU,並將運算自動分配到 GPU 上。要讓 TensorFlow 自動最佳化使用 GPU,你需要:
- 安裝 NVIDIA 驅動程式和 CUDA Toolkit。
- 安裝 GPU 版本的 TensorFlow。
在安裝 NVIDIA 驅動程式和 CUDA Toolkit 時,請確保安裝適用於你的 GPU 的版本,可以在 NVIDIA 網站上查看可用驅動程式的列表。
安裝 GPU 版本的 TensorFlow 時,需要使用 tensorflow-gpu 套件,可以用 pip 安裝:
pip install tensorflow-gpu
安裝完成後,TensorFlow 就會自動偵測可用的 GPU,並將運算自動分配到 GPU 上,不需要在程式中手動指定運算的裝置。
注意:如果你的系統中沒有可用的 GPU,TensorFlow 會使用 CPU。
不過要提醒一下:tensorflow-gpu 這個套件其實從 TensorFlow 2.1 開始就已經停止維護,現在已從 PyPI 上移除。因為從 2.1 版起,一般的 tensorflow 套件就內建 GPU 支援了,不需要(也不能)再另外裝 GPU 版。以我自己在 TF 2.x 上的安裝習慣,只要裝好 NVIDIA 驅動,再用 pip 裝官方套件即可:
pip install tensorflow
如果是 TensorFlow 2.14 以後的版本,連 CUDA Toolkit 和 cuDNN 都不用手動裝了,直接用:
pip install "tensorflow[and-cuda]"
它會一併帶入對應版本的 CUDA 相關套件。裝完後可以用 tf.config.list_physical_devices('GPU') 確認 TensorFlow 有沒有抓到你的 GPU,有列出來就代表環境建好了。
常見問題
為什麼 GPU 訓練模型比 CPU 快?
GPU 擁有數百甚至數千個運算單元,能夠同時處理大量數據;深度學習的矩陣運算正好是高度並行的工作,因此在單位時間內 GPU 的計算能力通常遠高於 CPU。
如何指定 TensorFlow 使用哪一張 GPU?
使用 tf.device('/gpu:0') 可以把運算指定到第一張 GPU。也可以搭配 tf.config.experimental.set_virtual_device_configuration 限制每張 GPU 可用的記憶體數量。
資料為什麼不能一直印出來看?
當資料被載入 GPU 後,就無法像 CPU 上的資料一樣直接用 print 查看內容。除錯時需要把資料搬回 CPU,或使用框架提供的除錯工具,這是開發 GPU 程式最主要的習慣差異。
沒有安裝 GPU 時 TensorFlow 會怎樣?
如果系統中沒有可用的 GPU,TensorFlow 會自動退回使用 CPU 執行運算,程式不會出錯,只是訓練速度會明顯變慢。
延伸閱讀
- 在 Python 使用 GPU:安裝正確 TensorFlow、PyTorch 與 CuPy 套件:同樣聚焦 Python、GPU,可接著比較不同情境的做法。
- 在 Python 裡面使用 GPU(一):選擇適合的 GPU:同樣聚焦 Python、GPU,可接著比較不同情境的做法。
- 限制 TensorFlow 跑模型時使用的 GPU 記憶體上限?:同樣聚焦 TensorFlow、GPU,可接著比較不同情境的做法。
最後更新
2026-08-28(原文發布於 2023-01-03,本文保留原始筆記內容並補上 GEO 結構。)
關於作者
Claire Chang | 企業 AI 導入與流程轉型顧問。專注於 AI Agent 架構設計、ERP 系統整合與企業 AI 治理。
首次發布:2023-01-03