今年 4 月,如果有人問我「現在要用哪個 AI 模型?」我一定會推薦 Claude。可是到了 9 月,同樣的問題,我會比較想推薦 OpenAI。這不是我突然改變立場,而是模型進步的速度真的太快了;不同工作適合的選擇,也一直在變。
我自己換工具還算容易,企業就沒那麼簡單了。假設一間公司好不容易把 AI Agent 接進客服、內部資料和工作流程,幾個月後發現另一個模型更適合,難道整套系統又要重做一次嗎?這也是我想寫這個系列的原因:在選模型之前,先想好未來要怎麼換。
為什麼企業不適合只押一個當下最推薦的模型?
企業選用 AI Agent 模型應以自己的任務表現為準,並保留重新評估的能力。模型推薦會隨時間、價格與工作情境改變,單次選型不應決定往後所有流程。
我不覺得會有一個模型可以長期獨霸天下。有的模型很適合陪我釐清一個模糊需求,但拿去大量處理固定格式的資料,可能又太貴;有的模型很便宜,只要任務拆得夠清楚,反而很適合跑重複工作。
所以企業要問的不是「哪一家現在最紅」,而是:這件工作它做得對不對?結果還要人工改多久?做錯的時候,我們找不找得到問題、能不能重跑?
我很喜歡看 OpenRouter Discover 的榜單,尤其是它的 Value leaders。上面把模型能力和價格放在一起看,能讓我很快找到一些原本不會注意到、但值得拿來試的模型。速度榜和使用量榜我也會看,只是它們各自回答不同的問題。
榜單不是採購答案。我 9 月比較想推薦 OpenAI,指的是我當時自己的使用情境;OpenRouter 的排名也不等於你公司的客服或訂單流程一定能跑得好。OpenRouter 對模型評估的說明同樣提醒,還是得拿自己的資料和工作來測。
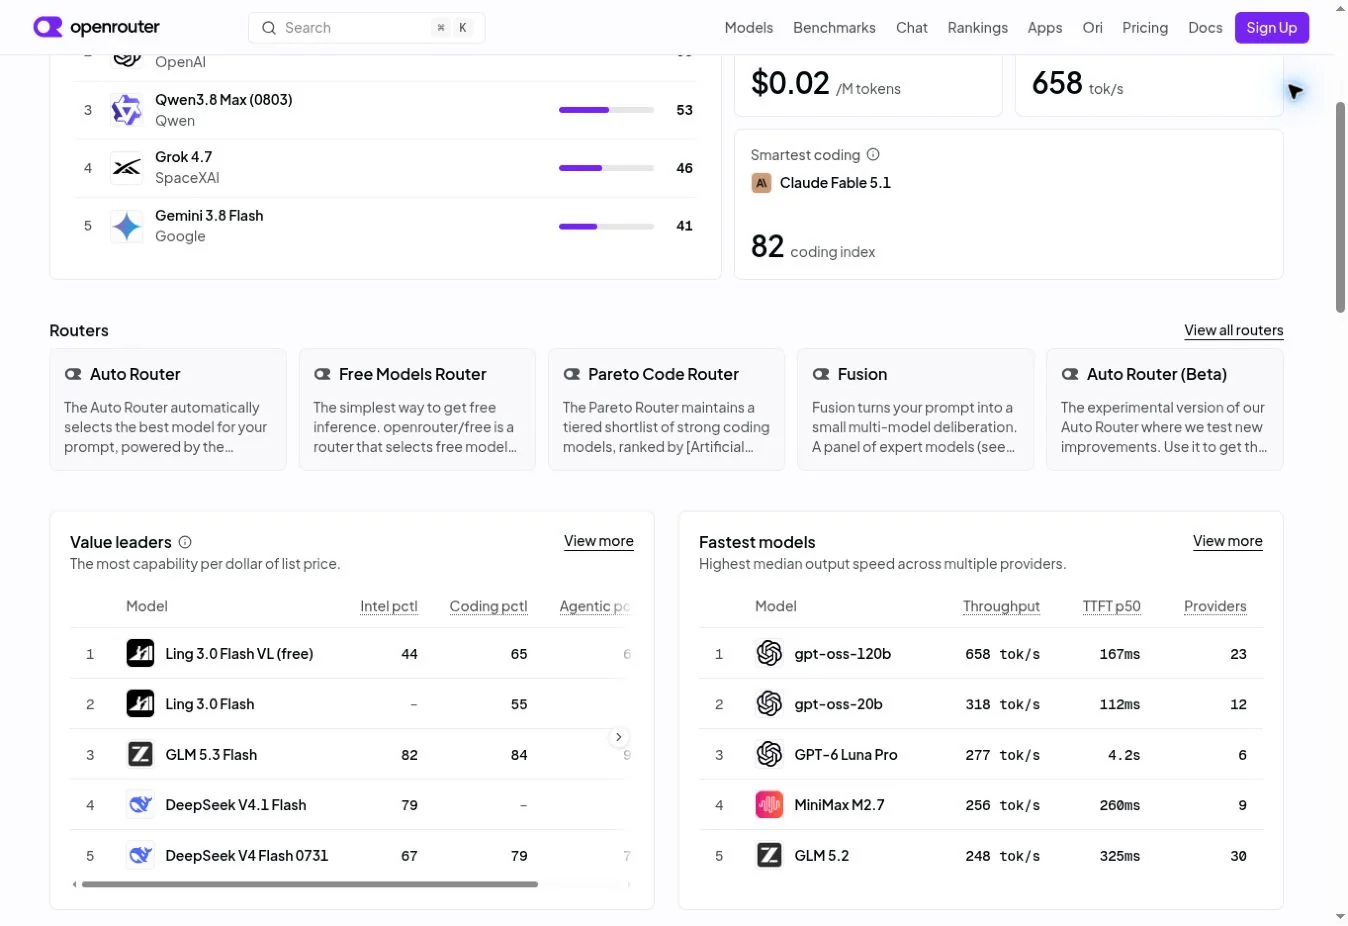
圖:OpenRouter Discover 的 Value leaders 總覽,截圖日期 2026-09-27。這是當時的榜單快照,名次與價格可能變動;右側的 Fastest models 是另一個速度榜。
前陣子我在自己的 AI 科技趨勢探索器裡也看到一句話,很適合放在這裡。Google Cloud 執行長 Thomas Kurian 在 Google Cloud Next ’26 的演講說:「We believe the future of AI must be open.」官方短片也用了「AI must be open」這句話。
我會把它理解成:企業應該保留選擇的空間。不過一句口號還不夠;真的要換模型時,能不能換,仍然取決於資料、API 和整個流程怎麼設計。
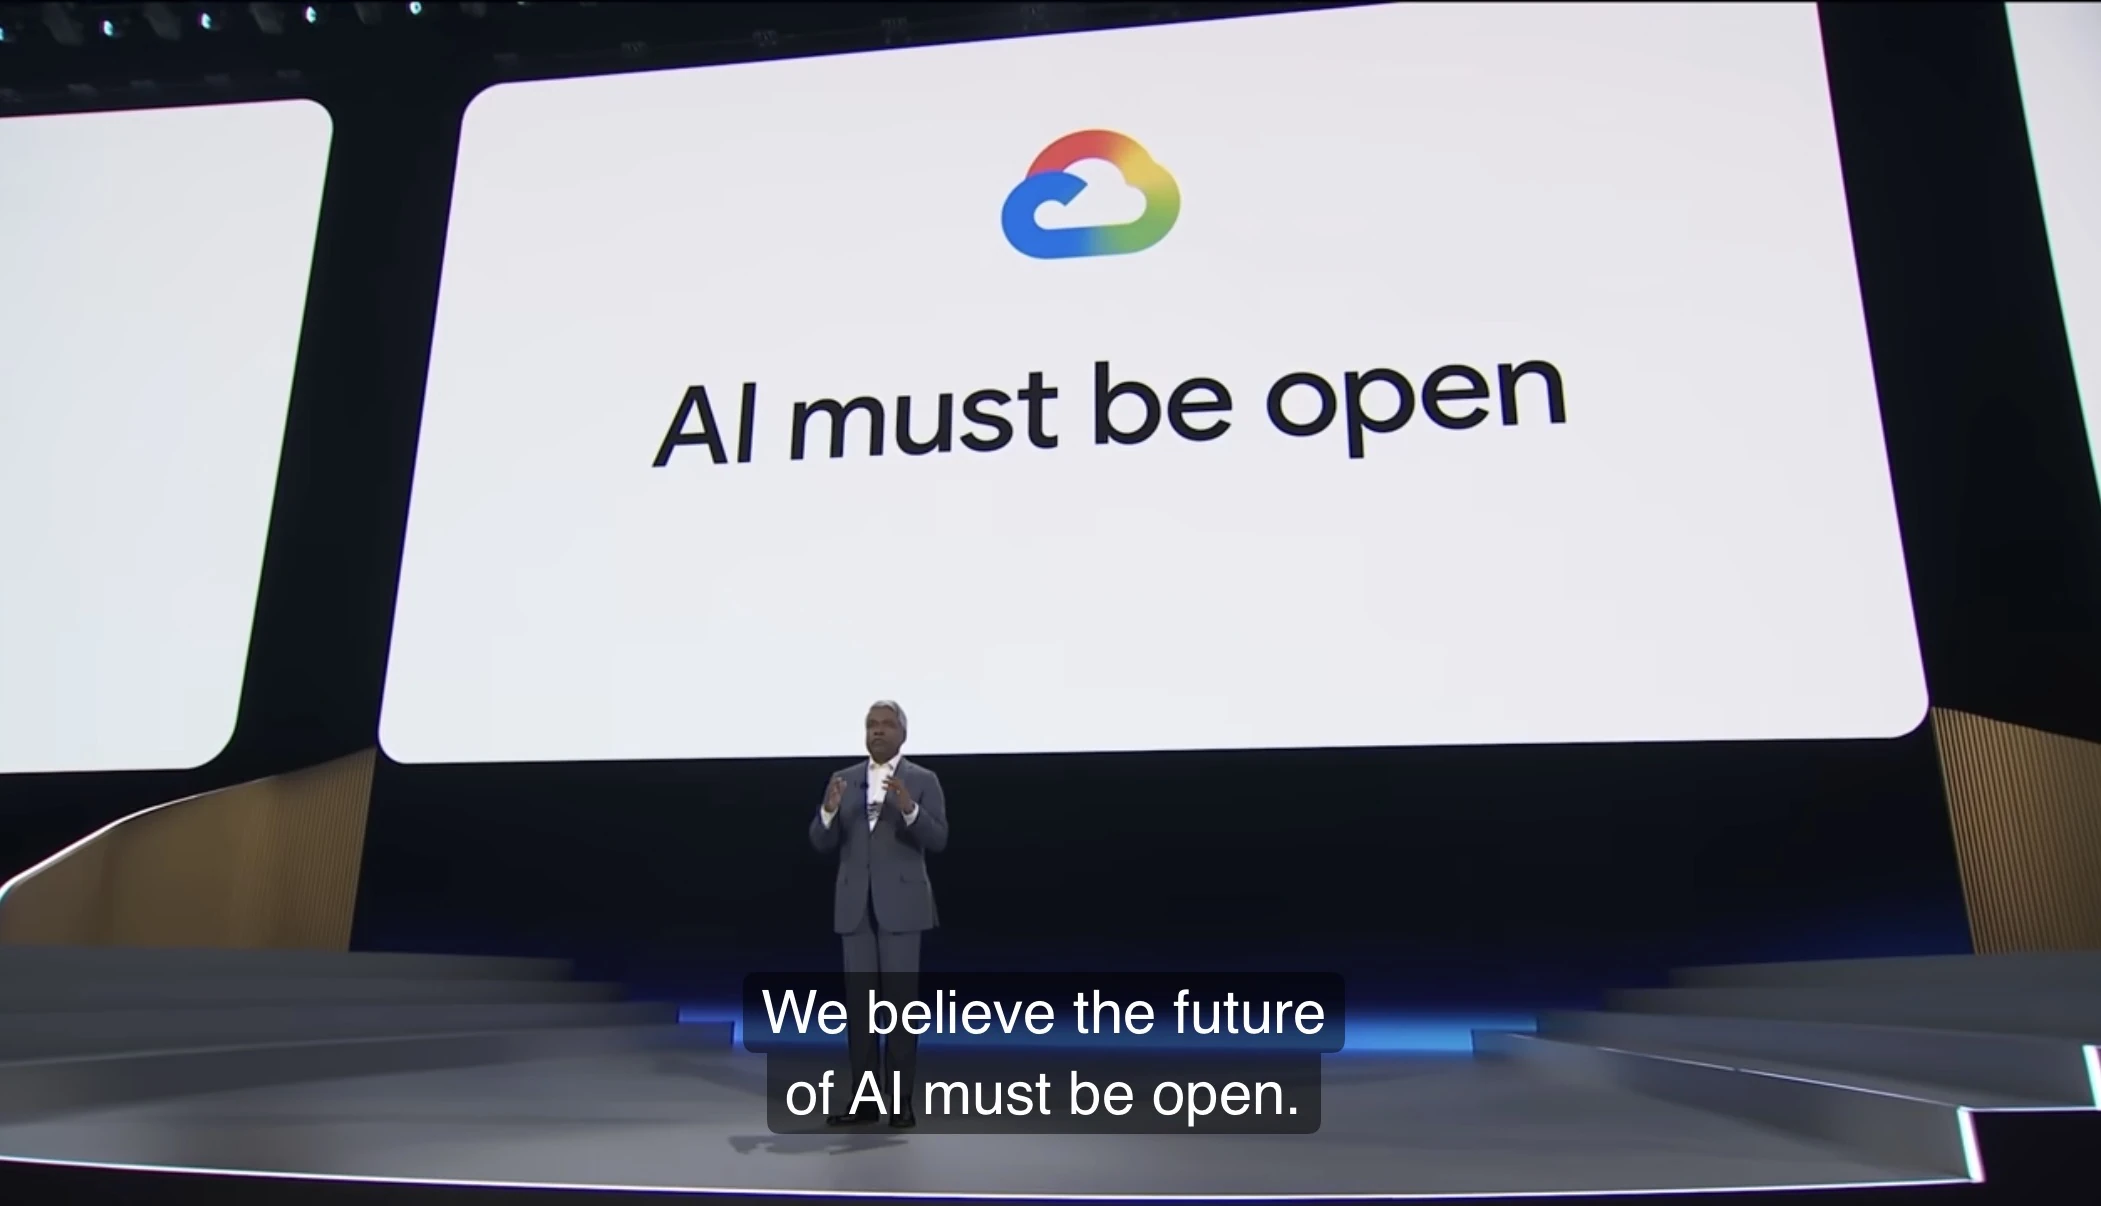
圖:Thomas Kurian 在 Google Cloud Next ’26 開幕演講說出該句時的畫面。
哪些部分要固定,哪些部分可以替換?
企業應固定任務規格、資料邊界、工具權限、輸出格式與驗收條件,將模型名稱及必要參數留在可調整的設定層。換模型後重新測試同一批任務,才能判斷效果是否改善。
舉個例子,假設公司要讓 AI 協助處理客戶來信。信進來後要辨識需求、查訂單、寫回覆草稿,最後交給客服確認。這裡我會先把「可以查哪些資料、什麼時候一定要交給人、誰能按下寄送」定下來。模型主要負責理解信件和起草文字,將來才比較有機會換掉其中一個模型,而不用連客服規則一起重做。
| 層次 | 優先固定的內容 | 可以調整的內容 |
|---|---|---|
| 任務與資料 | 輸入來源、可用欄位、個資遮罩 | 提供模型的資料表示方式 |
| 流程與權限 | 查詢、草稿、人工核准、送出邊界 | 哪個步驟使用哪個模型 |
| 模型接入 | 統一的呼叫介面與錯誤紀錄 | 模型名稱、版本、參數及供應商 |
| 驗收 | 必要欄位、禁止事項、代表案例 | 通過門檻及候選模型的比較結果 |
這是我在設計流程時會做的分工。但「能換模型」不代表隨便填一個新名稱就會成功。如果新模型不支援原本要用的工具,或輸出格式對不上,工程人員還是得先調整流程,必要時乾脆不要選它。
使用統一 API,換模型就只要改一個名稱嗎?
統一 API 能減少重複撰寫各家模型串接程式的工作,但不能保證模型行為一致。企業更換模型時,仍須檢查工具呼叫、欄位格式、錯誤處理與實際任務成果。
像 OpenRouter 的工具呼叫教學就示範過,同一套程式可以透過更換模型名稱,去測試不同供應商的模型。這很方便,我也喜歡這種彈性。但文件同時提醒,不是每個模型都支援工具呼叫。有時候程式收到了正常回應,模型卻只回一段文字,沒有真的呼叫系統預期的 tool_calls。表面上請求成功了,事情其實還沒做完。
所以我比較在意最後的工作有沒有完成。以客戶來信為例,查到的是不是正確訂單?有沒有只用公司允許的工具?草稿會不會自己答應退款?這些都得由流程和測試來檢查,不能只因為 API 回了成功,就算過關。
OpenRouter 的 model fallbacks可以在主要模型出錯、額度受限或暫時不能用時,換下一個模型試。這很像預先準備好備胎。但如果主要模型回了一個看起來格式正確、內容卻有問題的答案,備援機制未必會知道。這種錯誤還是要靠流程檢查,必要時交給人確認。
企業該怎麼比較模型的成果與成本?
企業應以同一批真實任務比較完成率、人工修正、重試次數、處理時間與 API 支出。模型單價只是成本的一部分,每件工作通過驗收的總成本才接近營運決策。
我自己有個很有感的例子。之前重整網站上 530 多篇舊文章,前面一批大約 100 篇用 GPT-5.6 Sol,API 花了約 100 美元。後來我把做法整理得更完整,交給 GLM-5.3 Flash 處理另一批 76 篇,跑三輪大約花 4 美元。換算下來,API 費用平均每篇大約從 1 美元變成 0.0526 美元,差不多是 1/19。完整過程我另外寫過一篇。
但我不會說這證明 GLM 跟高階模型一樣強。兩批文章本來就不同,後面那批還有先整理好的方法、跨模型檢查和人工抽查。比較準確的說法是:當我把工作拆清楚、把檢查方式設好,有些原本以為一定要用昂貴模型的工作,便宜模型也能完成。至於整體花了多少人力,不能只看 API 帳單。
| 比較欄位 | 為什麼要記 |
|---|---|
| 任務及資料範圍 | 確保候選模型處理的是可比較的工作 |
| 模型、版本與設定 | 日後能重現結果,避免模型更新後混淆 |
| 通過、失敗與重試數 | 看出便宜模型是否把費用轉成更多失敗 |
| 人工修正時間 | 算入交付一件合格工作的成本 |
| API 支出與處理時間 | 同時評估費用及使用者等待 |
| 不可犯錯項目 | 單獨記錄越權、捏造或錯誤承諾 |
所以我會拿 OpenRouter 的 Value leaders 當找候選名單的起點,看到便宜又有一定表現的模型,就拿實際任務試試看。榜單會變,排名也沒有算進我們人工修改的時間;最後要用哪個,還是要看自己的測試結果。
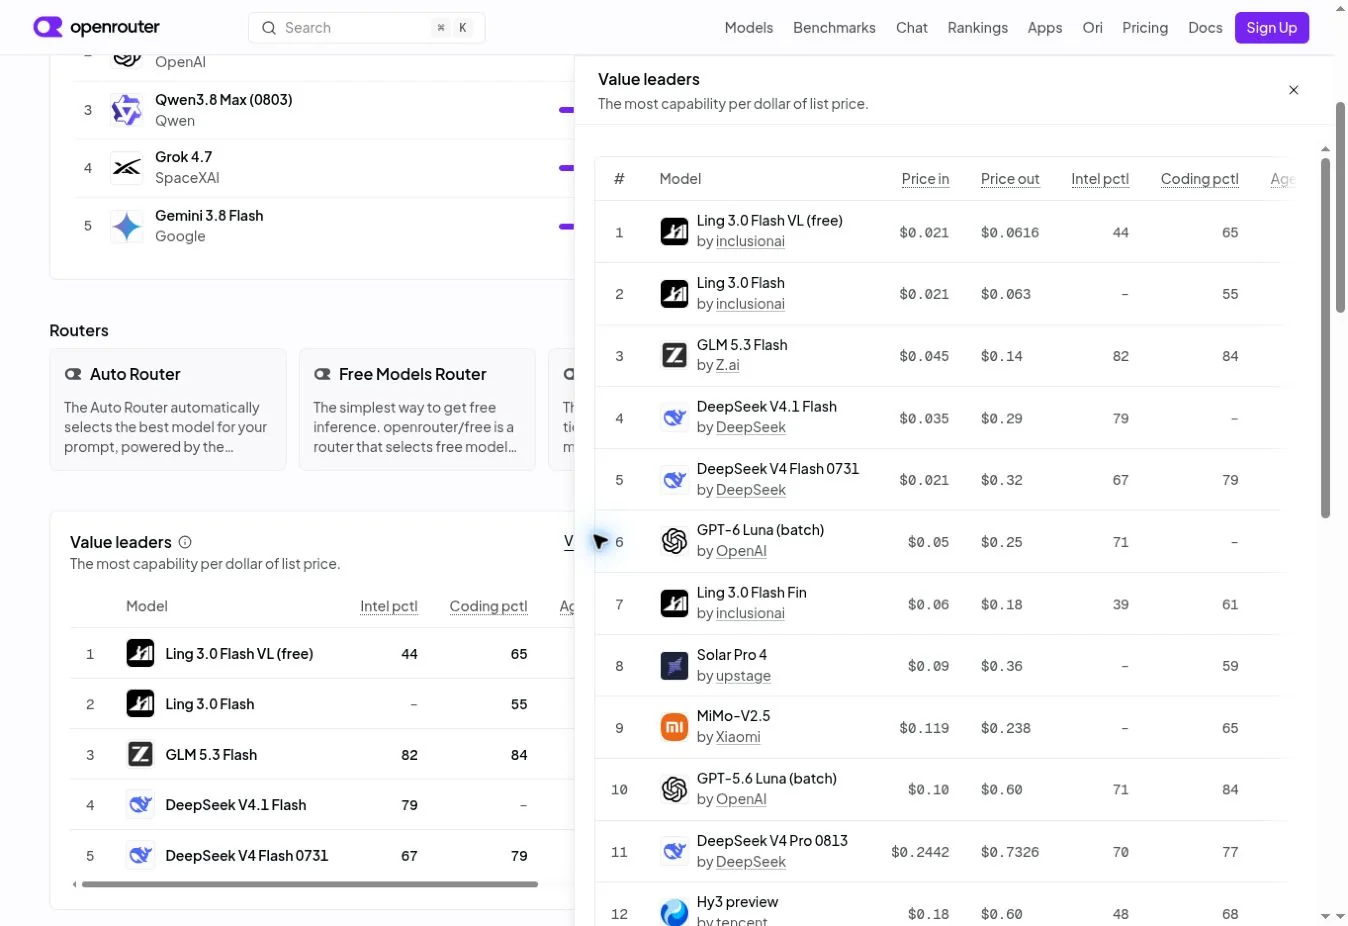
圖:2026-09-27 展開榜單的截圖,顯示模型、輸入與輸出標價及部分評估百分位。這些標價不是每件企業任務的完整成本,也不能把不同批次處理方式直接當成相同價格條件。
什麼時候切換模型,出了問題怎麼回退?
新模型通過固定任務與不可犯錯項目的驗收後,企業才適合逐步切換。切換時保留舊模型設定、觀察成本與錯誤,發現不符門檻就回退到已驗證版本。
如果公司想試新模型,我會先找一些平常會遇到的案例,也放進容易出錯的例外情況。讓新舊模型用同一份資料、提示詞、工具和評分方式跑一次,才看得出差別。OpenRouter 的 Ori Eval 說明也強調要固定測試環境和設定。
確認結果可以接受,我才會讓新模型先接一小部分工作。遇到欄位漏掉、工具叫錯,或同事修改答案的時間變長,就停下來找原因,必要時先切回原本的模型。
如果我是主管,我不會想看一長串 API 參數。我會先問四件事:新模型到底解決什麼問題?用哪些案例測過?每完成一件合格工作要花多少?出問題時誰可以先停下來、換回原本版本?工程人員則需要把模型版本、設定和測試結果記下來,才有辦法回答這些問題。
我也看到 Descript 在 2026 年 9 月分享的做法:他們把新模型的評估放進原本的工作流程,用自己的案例比較後再決定要不要換。企業規模和我們可能不同,不必照抄評估頻率;我比較想借用的是這個想法:試新模型應該是一件可以重複做的事,不必每次都重新開一個整合專案。
企業 AI Agent 模型選型常見問題
企業選型時最常混淆的是多模型、統一 API、模型備援與成本排行的用途。這些工具能減少切換成本、提供候選名單,但正式決策仍要依公司任務的驗收結果。
企業一定要同時使用多個模型嗎?
不一定。第一個流程可以先使用一個通過測試的模型,但要記錄任務規格與驗收案例,並把模型設定留在容易調整的位置。日後有價格、能力或供應情況變化時,才有辦法比較新的候選者。
有了 OpenRouter,換模型還需要重新測試嗎?
需要。統一 API 可以簡化串接,卻不保證各模型支援相同工具或產生相同品質的答案。至少要重跑必要欄位、工具呼叫、例外件與禁止事項的測試。
Value leaders 排名最高的模型,是否就是最適合企業的模型?
不一定。OpenRouter 的 Value leaders 依標價與能力提供選型線索;企業仍應檢查實際任務品質、資料處理條件、工具支援、延遲和人工修正成本。排名也會隨頁面資料更新。
模型備援和主動更換模型有什麼不同?
模型備援是在主要模型出現特定錯誤時,自動嘗試候補模型;主動更換模型則是企業經過測試後,調整正式流程的預設模型。兩者都要事先確認候選模型符合流程要求。
便宜模型在什麼情況下反而比較貴?
如果便宜模型經常漏欄位、反覆重試,或讓員工花更多時間修改,每件合格工作的總成本可能增加。比較時應把 API 支出、重試與人工處理一起計算。
參考資料
- OpenRouter,Discover models:Value leaders,存取日期:2026-09-27。
- Google Cloud,Next ’26 開幕演講影片,1:35:56,2026-04-22,存取日期:2026-09-27。
- Google Cloud,官方短片「AI must be open」,2026-04-22,存取日期:2026-09-27。
- OpenRouter,Ori Eval: Find the Best Model for What You're Building,2026-08-03,存取日期:2026-09-27。
- OpenRouter,Tool Calling Across Any Model,2026-08-12,存取日期:2026-09-27。
- OpenRouter,Model Fallbacks 文件,日期不明,存取日期:2026-09-27。
- OpenRouter,Two Hours of Work That Takes a Week,2026-09-21,存取日期:2026-09-27。
- Claire Chang,530 篇舊文章如何用 AI Agent 重整?,2026-08-28,存取日期:2026-09-27。
延伸閱讀
- AI Agent 落地五層診斷:先從目標、流程、知識、信任與營運檢查導入條件。
- 企業導入前必懂的 MCP、Skills、Automation:了解 Agent 如何連接工具與保存工作方法。
- 如何串接 Email、ERP 與企業資料,自動執行完整工作流程?:看具體權限與人工核准設計。
關於作者
Claire Chang | 企業 AI 導入與流程轉型顧問。專注於 AI Agent 架構設計、ERP 系統整合與企業 AI 治理。
首次發布:2026-09-27