
pgvector 是一個開源套件,能讓 PostgreSQL 直接儲存向量並執行相似度搜尋,不需要另外架設專用的向量資料庫。只要在既有的 PostgreSQL 上安裝這個延伸套件,就能把 embedding 跟其他關聯式資料放在同一張表裡查詢。
pgvector 支援哪些向量搜尋功能?
pgvector 支援精確與近似最近鄰搜索,涵蓋單精度、半精度、二進位與稀疏向量等多種資料型態,距離計算則提供 L2 距離、內積、餘弦距離、L1 距離、漢明距離與 Jaccard 距離。任何有 PostgreSQL 用戶端的語言都能呼叫它,而且完全相容 ACID、時間點恢復、JOIN 等 PostgreSQL 原生功能,等於是在不犧牲關聯式資料庫特性的前提下,多了一種向量欄位可以用。
專案頁面在 github.com/pgvector/pgvector。
如何在 Linux 上安裝 pgvector?
從原始碼編譯安裝即可,指令很短:
cd /tmp
git clone --branch v0.7.2 https://github.com/pgvector/pgvector.git
cd pgvector
make
make install # may need sudo
如何在 Windows 上安裝 pgvector?
Windows 環境需要先裝好 C++ 編譯工具鏈,再用 nmake 編譯。步驟如下:
-
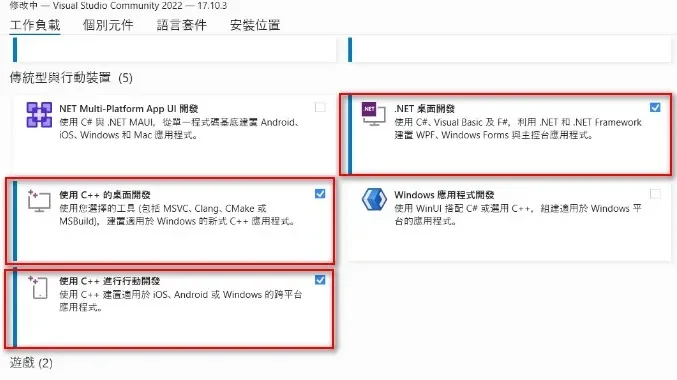
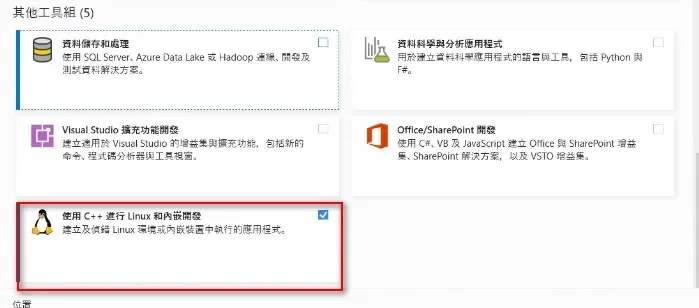
安裝 Visual Studio,並在元件勾選畫面中至少選取「使用 C++ 的桌面開發」與「使用 C++ 進行行動開發」等 C/C++ 相關工作負載。
-
開啟 C 語言編譯環境:
call "C:\Program Files\Microsoft Visual Studio\2022\Community\VC\Auxiliary\Build\vcvars64.bat"
- 用 nmake 編譯並安裝:
set "PGROOT=C:\Program Files\PostgreSQL\16"
cd %TEMP%
git clone --branch v0.7.2 https://github.com/pgvector/pgvector.git
cd pgvector
nmake /F Makefile.win
nmake /F Makefile.win install
如何建立可以儲存向量的資料表欄位?
pgvector 的資料型別是 vector(N),括號內的數字代表向量長度,例如 OpenAI 的 embedding 長度是 1536。建表時直接把欄位型別指定為 vector(1536) 即可:
CREATE TABLE IF NOT EXISTS public.test_example
(
    id character varying(255) COLLATE pg_catalog."default" NOT NULL,
    embeddings vector(1536),
    CONSTRAINT test_example_pkey PRIMARY KEY (id)
)
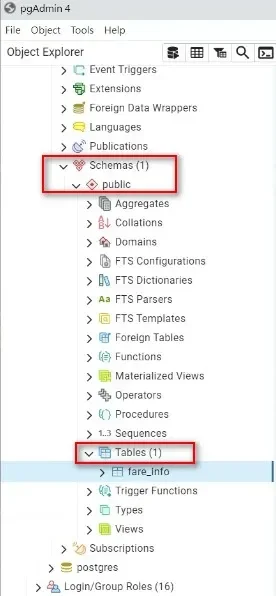
用 pgAdmin 之類的工具管理時,在 Object Explorer 對資料庫按右鍵選擇 Query Tool 就能開啟 SQL 輸入介面;現有的表格則能從 Schemas -> Tables 底下瀏覽到。
如何把 embedding 資料寫入資料表?
把 CSV 裡的 embedding 字串轉成浮點數陣列後,用 psycopg2 逐筆寫入即可,跟寫入一般欄位沒有差別:
import psycopg2
df = pd.read_csv('./data.csv')
def convert_embedding(embedding_str):
    return list(map(float, embedding_str.split(',')))

df["embeddings"] = df["embeddings"].apply(literal_eval)

row = df.iloc[0]
sql = """
    INSERT INTO fare_info (
        id, embeddings
    ) VALUES (
        %s, %s
    )
"""

conn = psycopg2.connect(dbname="myDB", user="myUser", password="xxxxxx")
cursor = conn.cursor()
cursor.execute(sql, (row['id'],row['embeddings']))
conn.commit()
pgvector 資料量變大時,有哪些擴充選項?
單機 PostgreSQL 搭配 pgvector 在資料量成長到一定規模後,查詢延遲會隨之上升,這時可以考慮阿里巴巴雲推出的 AnalyticDB。AnalyticDB 是基於 PostgreSQL 開發的雲原生資料倉儲,同樣支援 pgvector 語法,但額外做了幾項強化:
| 能力 | pgvector(單機 PostgreSQL) | AnalyticDB |
|---|---|---|
| 向量搜索架構 | 單機處理 | 可將向量資料分佈到多節點並行處理,處理大型資料集更快 |
| 向量壓縮 | 無 | 支援,可減少儲存空間 |
| 向量索引 | 依賴 pgvector 原生索引 | 額外提供向量索引,加快查詢速度 |
換句話說,AnalyticDB 中的 pgvector 用法與一般 PostgreSQL 相同,差別在底層的分散式向量搜索、向量壓縮與向量索引,這些強化讓它更適合處理大型向量資料集。
常見問題
pgvector 需要另外裝一套向量資料庫嗎?
不需要。pgvector 是 PostgreSQL 的延伸套件,安裝後既有的資料庫就能直接多出 vector 型別欄位,向量資料跟關聯式資料共用同一張表、同一個交易機制。
vector(1536) 裡的 1536 是固定的嗎?
不是固定值,1536 只是因為對應 OpenAI 的 embedding 長度。改用其他模型時,欄位長度要換成該模型輸出的向量維度。
單機 pgvector 什麼時候該換成 AnalyticDB?
當向量資料量大到單機查詢延遲明顯上升,或需要跨節點平行處理與向量壓縮時,可以評估 AnalyticDB 這類基於 PostgreSQL 的雲原生方案。
參考資料
- pgvector,GitHub 官方專案 README(安裝方式、向量型別與距離運算說明),存取日期:2026-08-27。https://github.com/pgvector/pgvector
延伸閱讀
- RAG 檢索資料準備指南:切分、向量化與索引設計:同樣聚焦 向量搜尋,可接著比較不同情境的做法。
- PostgreSQL 和 pgAdmin 安裝教學:Linux 指令、連線設定與常見錯誤:同樣聚焦 PostgreSQL,可接著比較不同情境的做法。
- PostgreSQL 設定與操作教學:CentOS 服務檢查、遠端連線、psql 與 pgAdmin:同樣聚焦 PostgreSQL,可接著比較不同情境的做法。
關於作者
Claire Chang | 企業 AI 導入與流程轉型顧問。專注於 AI Agent 架構設計、ERP 系統整合與企業 AI 治理。
首次發布:2024-06-28